توکن چیست؟ محاسبهٔ هزینهٔ هر درخواست API هوش مصنوعی
توکن واحد شمارش متن در مدلهای Claude و GPT است و هزینهٔ API با همین واحد حساب میشود. با یک مثال واقعی از Claude Code ببین هر درخواست چقدر خرج دارد.
توکن کوچکترین تکهٔ متنی است که مدلهای زبانی مثل Claude و GPT میخوانند و مینویسند؛ معمولاً یک کلمهٔ کوتاه، بخشی از یک کلمهٔ بلند یا یک علامت. هزینهٔ هر درخواست API هم با همین واحد حساب میشود: تعداد توکنهای ورودی × قیمت ورودی + تعداد توکنهای خروجی × قیمت خروجی. قیمتها برای هر ۱ میلیون توکن اعلام میشوند؛ مثلاً قیمت رسمی Claude Sonnet 5.5 برای هر میلیون توکن ورودی $2 و برای هر میلیون توکن خروجی $10 است.
در این مطلب میبینی توکن دقیقاً چیست، چرا فارسی نوشتن توکن بیشتری میخورد، پنجرهٔ کانتکست چه ربطی به هزینه دارد و یک نوبت کار واقعی در Claude Code چقدر خرج دارد.
توکن چیست؟
مدل زبانی متن را حرفبهحرف یا کلمهبهکلمه نمیبیند. اول یک ابزار به اسم tokenizer متن را به تکههایی از یک واژهنامهٔ ثابت میشکند و به هر تکه یک عدد میدهد. مدل با همین عددها کار میکند و جوابش را هم توکنبهتوکن میسازد. برای همین است که جواب در Claude Code یا هر چتبات دیگری تکهتکه روی صفحه میآید.
کلمههای پرتکرار انگلیسی مثل the یا function معمولاً یک توکناند. کلمههای کمکاربرد، اسمهای خاص و اسم متغیرهای عجیب در کد به چند توکن شکسته میشوند. فاصله، نقطه، ویرگول و تورفتگی کد هم سهمی از توکنها دارند.
- در متن انگلیسی هر توکن بهطور میانگین حدود ۴ کاراکتر است.
- ۱٬۰۰۰ توکن تقریباً برابر ۷۵۰ کلمهٔ انگلیسی است.
- کد پر از علامت، براکت و تورفتگی است و هر کدام از اینها هم توکن حساب میشوند.
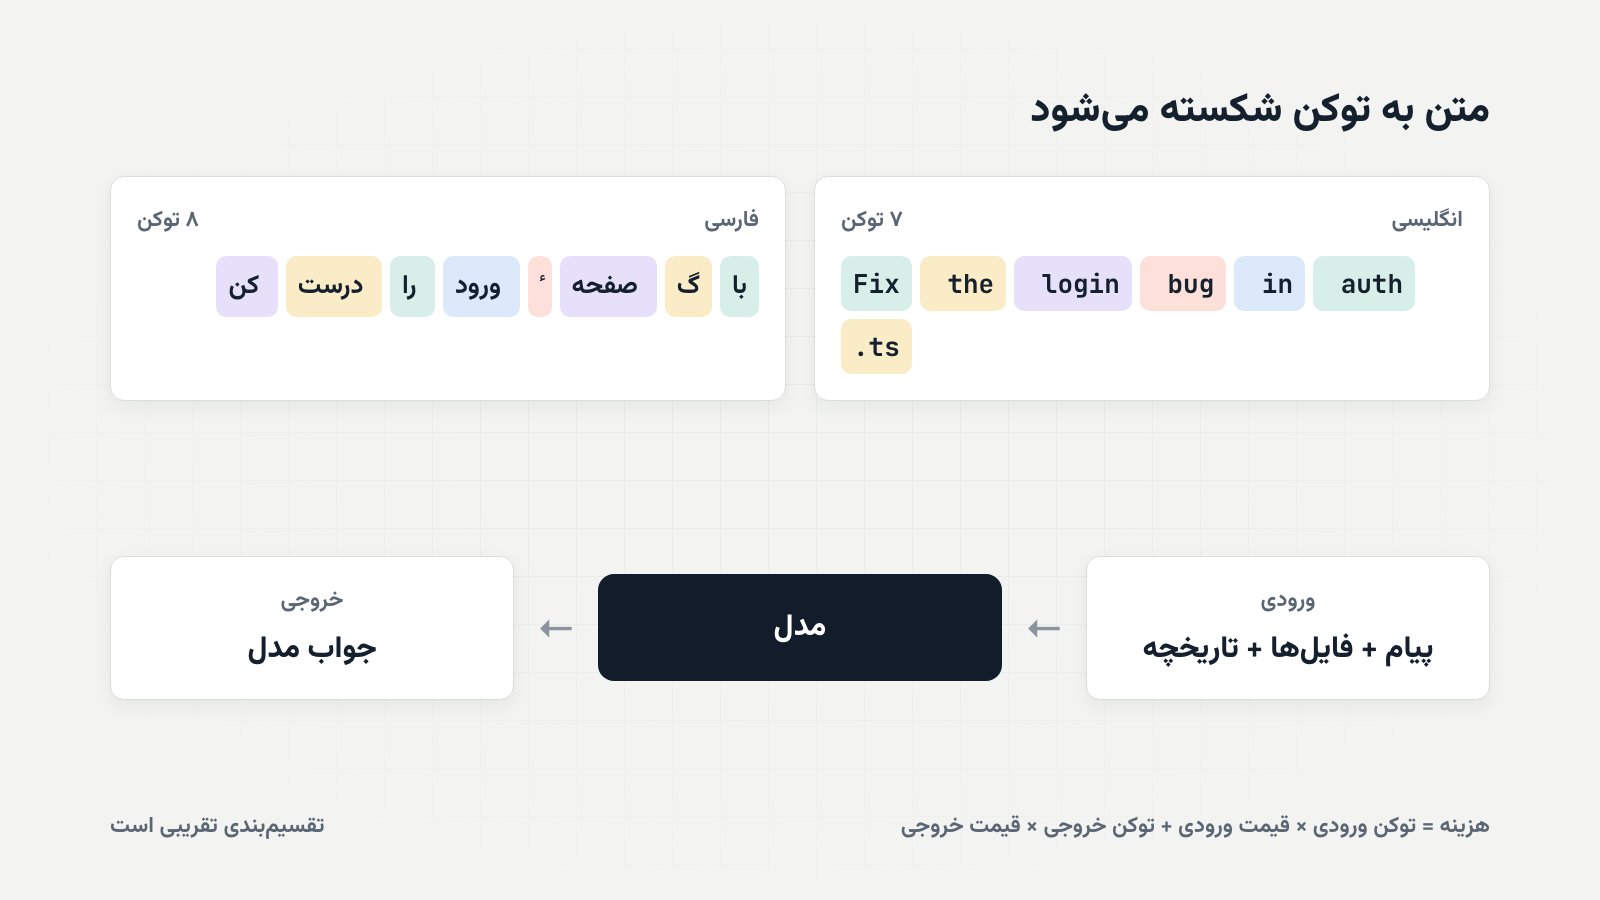
چرا متن فارسی توکن بیشتری مصرف میکند؟
tokenizerها روی حجم عظیمی از متن ساخته شدهاند که بیشترش انگلیسی است. نتیجه این است که برای کلمههای انگلیسی تکههای بزرگ و کامل در واژهنامه وجود دارد، اما کلمههای فارسی اغلب به چند تکهٔ کوچکتر شکسته میشوند. یک جملهٔ فارسی معمولاً توکن بیشتری از ترجمهٔ انگلیسی همان جمله لازم دارد. بسته به مدل و متن، این اختلاف میتواند محسوس باشد و گاهی به دو برابر هم برسد.
این در عمل یعنی:
- پرامپتهای طولانی فارسی، مثل دستورالعملهای ثابتی که در هر درخواست تکرار میشوند، هزینهٔ ورودی بیشتری دارند.
- جوابهای فارسی توکن خروجی بیشتری میخورند و خروجی گرانترین بخش قیمت است.
- فارسی نوشتن هیچ اشکالی ندارد و مدلهای امروزی فارسی را خوب میفهمند. فقط اگر متن ثابت و طولانیای داری که در هزاران درخواست تکرار میشود، نوشتنش به انگلیسی هزینه را پایین میآورد.
در کار روزمره با Claude Code یا Codex این موضوع کمتر به چشم میآید، چون بیشتر ورودی کد و محتوای فایلهاست، نه متن فارسی. آنجا سهم بزرگ هزینه از جای دیگری میآید: کانتکست.
پنجرهٔ کانتکست (Context Window) چیست؟
مدل حافظه ندارد. هر بار که درخواستی میفرستی، همهٔ چیزهایی که مدل باید بداند همراه همان درخواست فرستاده میشود: پرامپت سیستمی، تاریخچهٔ گفتگو، محتوای فایلها و خروجی دستورهایی که قبلاً اجرا شدهاند. به مجموع اینها کانتکست میگویند و پنجرهٔ کانتکست سقف تعداد توکنی است که مدل در یک درخواست میتواند ببیند. سقف دقیق هر مدل را در مستندات همان مدل ببین.
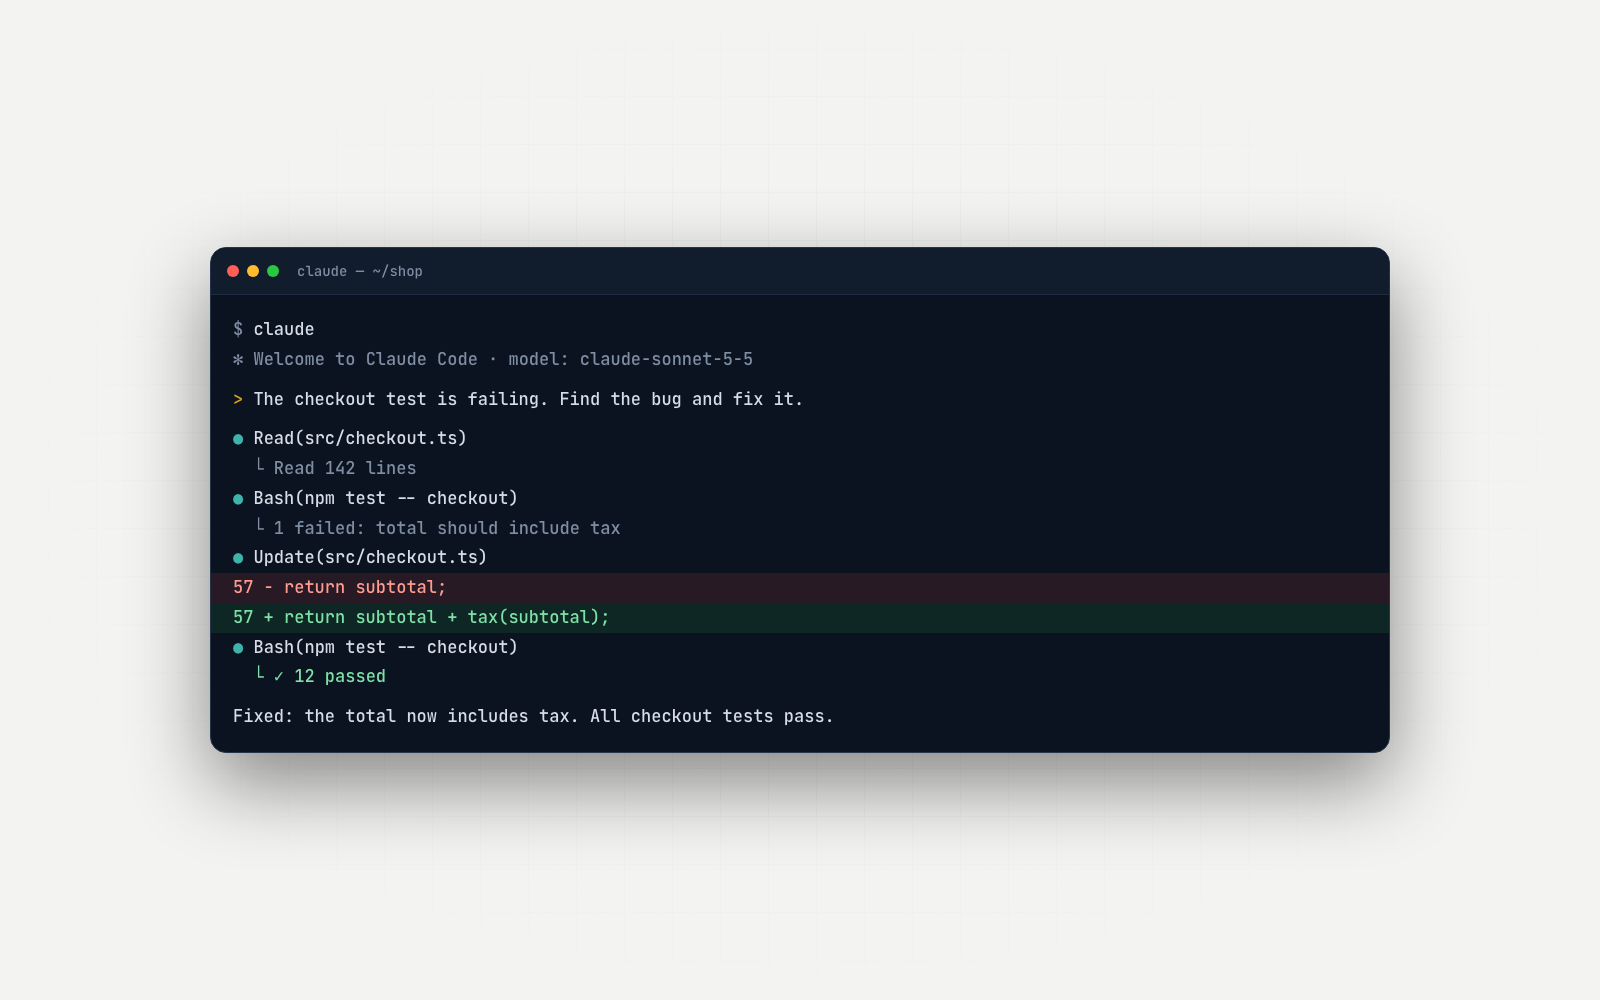
نکتهٔ مهم برای هزینه این است که هر پیام جدید در یک گفتگوی طولانی، کل تاریخچهٔ قبلی را دوباره بهعنوان ورودی میفرستد. پیام بیستم یک جلسه فقط چند خط سؤال تو نیست؛ نوزده پیام قبلی و فایلهایی که خوانده شدهاند هم دوباره حساب میشوند. به همین دلیل یک نوبت معمولی در Claude Code دهها هزار توکن ورودی دارد، در حالی که جواب مدل فقط چند صد تا چند هزار توکن است.
توکن ورودی، خروجی و کش چه فرقی دارند؟
قیمت هر مدل معمولاً از سه بخش تشکیل میشود:
- ورودی (input): هر چیزی که به مدل میفرستی؛ پرامپت، تاریخچه، فایلها و تعریف ابزارها.
- خروجی (output): هر چیزی که مدل تولید میکند؛ متن جواب، کد و فراخوانی ابزارها. مدل ورودی را یکجا پردازش میکند اما خروجی را توکنبهتوکن میسازد، برای همین خروجی در بیشتر مدلهای Claude و GPT حدود ۵ برابر ورودی قیمت دارد.
- خواندن از کش (cache read): وقتی ابتدای درخواست دقیقاً همان ابتدای درخواست قبلی باشد، آن بخش از کش خوانده میشود و خیلی ارزانتر از ورودی تازه حساب میشود؛ مثلاً در Claude Sonnet 5.5 حدود $0.20 برای هر ۱ میلیون توکن، یعنی یکدهم ورودی عادی.
| مدل | ورودی (هر ۱ میلیون توکن) | خروجی (هر ۱ میلیون توکن) |
|---|---|---|
| Claude Opus 5.5 | $4 | $20 |
| Claude Sonnet 5.5 | $2 | $10 |
| Claude Haiku 4.5 | $1 | $5 |
| Claude Fable 5.1 | $10 | $50 |
| GPT-6.1 Sol | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
اینها قیمتهای رسمی فهرستشدهاند. برای توضیح کاملتر و مقایسهٔ مدلها، مطلب قیمت API Claude و GPT را بخوان.
مثال: هزینهٔ یک درخواست در Claude Code چقدر است؟
فرض کن با Claude Sonnet 5.5 روی یک پروژه کار میکنی و در یک نوبت، Claude Code این مقدار توکن میفرستد و میگیرد:
- ۴۰٬۰۰۰ توکن ورودی: پرامپت سیستمی، چند فایل و تاریخچهٔ گفتگو
- ۱٬۵۰۰ توکن خروجی: توضیح کوتاه و تغییرات کد
بدون کش
ورودی: ۴۰٬۰۰۰ ÷ ۱٬۰۰۰٬۰۰۰ × $2 = $0.08. خروجی: ۱٬۵۰۰ ÷ ۱٬۰۰۰٬۰۰۰ × $10 = $0.015. جمع: حدود $0.095 برای یک نوبت.
با کش
در نوبتهای بعدی بیشتر کانتکست تکراری است. فرض کن ۳۵٬۰۰۰ توکن از کش خوانده شود و فقط ۵٬۰۰۰ توکن تازه باشد. کش: ۳۵٬۰۰۰ × $0.20 ÷ ۱ میلیون = $0.007. ورودی تازه: ۵٬۰۰۰ × $2 ÷ ۱ میلیون = $0.01. خروجی همان $0.015. جمع: حدود $0.032، یعنی کمتر از یکسوم حالت بدون کش.
| حالت | هزینهٔ هر نوبت | هزینهٔ ۵۰ نوبت |
|---|---|---|
| بدون کش | $0.095 | حدود $4.75 |
| با کش | $0.032 | حدود $1.60 |
اگر همین کار را با Claude Opus 5.5 انجام دهی، چون قیمتش دو برابر Sonnet 5.5 است، هزینه هم تقریباً دو برابر میشود. با Claude Fable 5.1 یا GPT-6 Astra هزینه چند برابر بالاتر میرود. برای کار روزانه، Sonnet 5.5 یا GPT-6.1 Sol بیشتر کیفیت را با هزینهٔ خیلی کمتر میدهند؛ مدل گران را برای مسئلههای واقعاً سخت نگه دار.
چطور مصرف توکن را کم کنیم؟
- برای هر کار جدا، جلسهٔ تازه باز کن. در Claude Code دستور
/clearکانتکست را خالی میکند. ادامه دادن یک گفتگو برای ده کار نامرتبط یعنی هر پیام، بار همهٔ کارهای قبلی را هم با خودش میبرد. - گفتگوهای طولانی را فشرده کن. دستور
/compactدر Claude Code تاریخچه را خلاصه میکند تا ورودی نوبتهای بعد کوچکتر شود. - مدل را با کار جور کن. با
/modelبین مدلها جابهجا شو؛ برای کارهای ساده Claude Haiku 4.5 کافی است. - فایلهای بزرگ و بیربط را دور نگه دار. خروجی build، فایلهای lock و لاگهای طولانی را جلوی مدل نگذار؛ هر خط آنها توکن است.
- دستورالعملهای ثابت را کوتاه بنویس. متنی که در هر درخواست تکرار میشود، مثل فایل
CLAUDE.md، را خلاصه و دقیق نگه دار. - جواب کوتاه بخواه. اگر فقط کد لازم داری، بگو توضیح اضافه ندهد؛ خروجی گرانترین بخش است.
برای نصب و تنظیم Claude Code و دستورهای بیشتر، آموزش نصب Claude Code را ببین. اگر با Codex کار میکنی، راهاندازی Codex CLI هم همین منطق را دارد.
هزینهٔ هر درخواست را کجا ببینیم؟
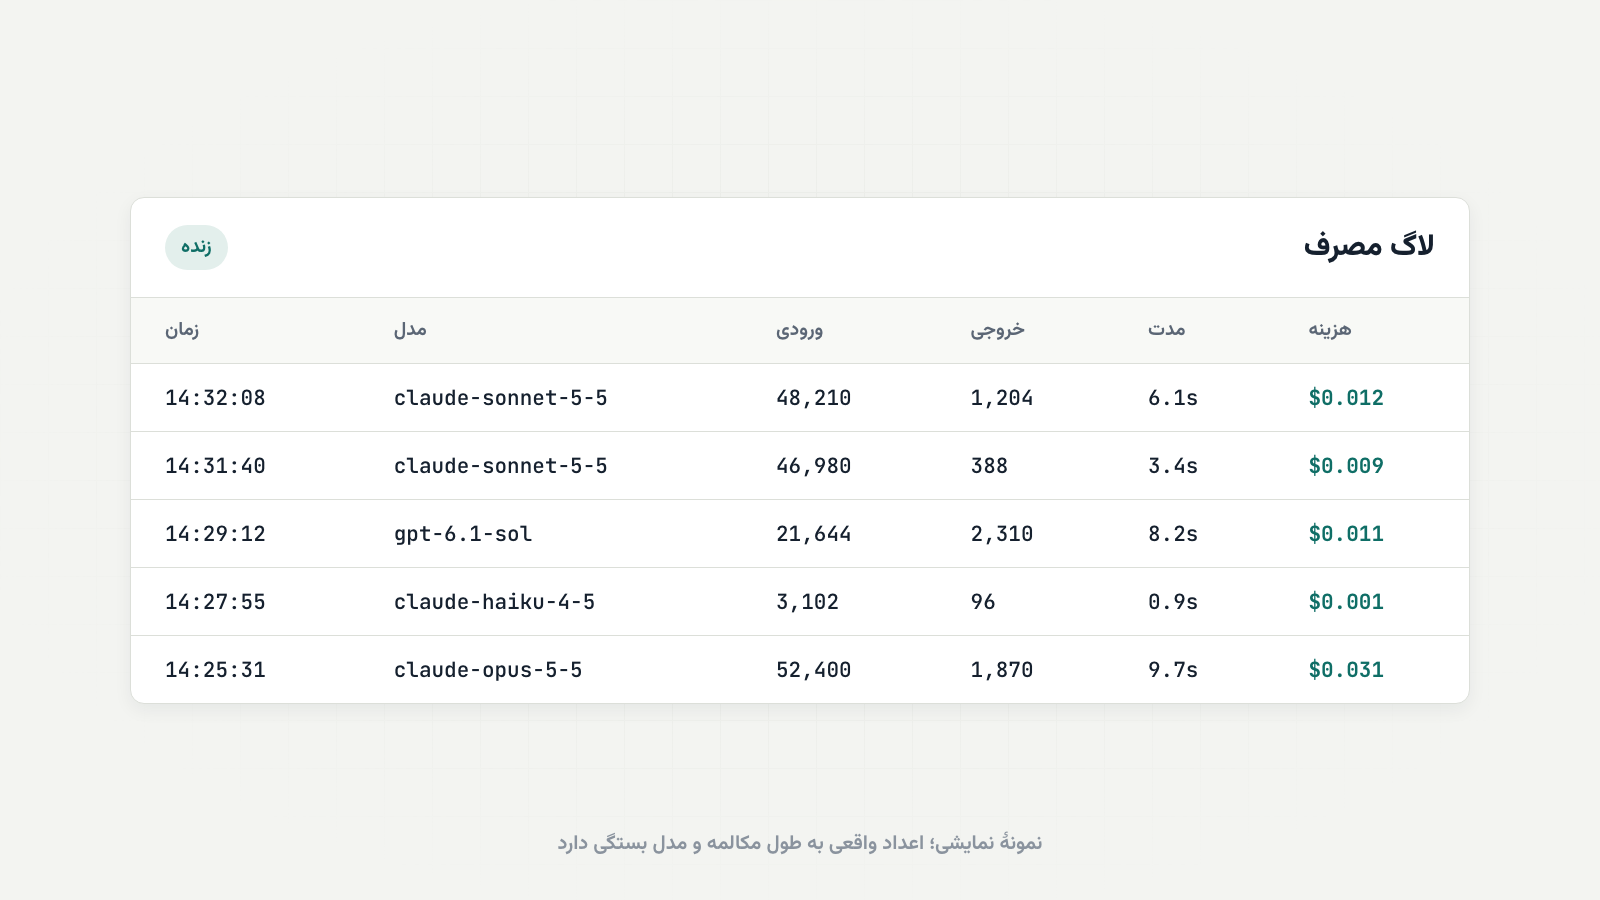
حساب کردن روی کاغذ برای فهمیدن منطق خوب است، اما عدد واقعی را باید در لاگ دید. در پاسخ هر درخواست API، بخش usage تعداد توکنهای ورودی، خروجی و کش را برمیگرداند. وقتی از ابزاری مثل Claude Code یا Cursor استفاده میکنی، این عددها را مستقیم نمیبینی و لاگ سرویسی که کلید API را از آن گرفتهای بهترین مرجع است.
در LLMPass، کنسول برای هر درخواست مدل، تعداد توکنها، مدت زمان و هزینه را نشان میدهد. با یک کلید API به مدلهای Claude و GPT در Claude Code، Codex، Cursor و Cline وصل میشوی و قیمتها ۵۰٪ ارزانتر از قیمت رسمی API است. برای هر کلید میتوانی سقف خرج بگذاری تا یک جلسهٔ طولانی غافلگیرت نکند. درخواستهای ناموفق هم هزینهای ندارند.
| مدل | ارزانتر | ورودی | خروجی |
|---|---|---|---|
| Claude Opus 5.5Claude Code · API | −۵۰٪ | $2.00 | $10.00 |
| Claude Sonnet 5.5Claude Code · API | −۵۰٪ | $1.00 | $5.00 |
| Claude Sonnet 5Claude Code · API | −۵۰٪ | $1.00 | $5.00 |
| Claude Haiku 4.5Claude Code · API | −۵۰٪ | $0.50 | $2.50 |
| Claude Opus 5پرمصرفClaude Code · API | −۵۰٪ | $2.50 | $12.50 |
| Claude Fable 5.1پرمصرفClaude Code · APIپس از اولین شارژ | −۵۰٪ | $5.00 | $25.00 |
| Claude Fable 5پرمصرفClaude Code · APIپس از اولین شارژ | −۵۰٪ | $5.00 | $25.00 |
| Claude Opus 4.8پرمصرفClaude Code · API | −۵۰٪ | $2.50 | $12.50 |
| Claude Opus 4.7پرمصرفClaude Code · API | −۵۰٪ | $2.50 | $12.50 |
| Claude Opus 4.6پرمصرفClaude Code · API | −۵۰٪ | $2.50 | $12.50 |
| Claude Opus 4.5پرمصرفClaude Code · API | −۵۰٪ | $2.50 | $12.50 |
| Claude Sonnet 4.6Claude Code · API | −۵۰٪ | $1.50 | $7.50 |
| Claude Sonnet 4.5Claude Code · API | −۵۰٪ | $1.50 | $7.50 |
| GPT-6 SolCodex · API | −۵۰٪ | $1.00 | $5.00 |
| GPT-6.1 SolCodex · API | −۵۰٪ | $1.00 | $5.00 |
| GPT-6 AstraپرمصرفCodex · APIپس از اولین شارژ | −۵۰٪ | $5.00 | $25.00 |
| GPT-5.6 SolپرمصرفCodex · API | −۵۰٪ | $2.50 | $15.00 |
| GPT-5.5پرمصرفCodex · API | −۵۰٪ | $2.50 | $15.00 |
| Kimi K2.7 CodeClaude Code · APIپس از اولین شارژ | −۴۰٪ | $0.57 | $2.40 |
| MiniMax M3Claude Code · APIپس از اولین شارژ | −۴۰٪ | $0.18 | $0.72 |
| Gemini 3.8 FlashAPIپس از اولین شارژ | −۴۰٪ | $0.45 | $2.25 |
| Grok 4.7APIپس از اولین شارژ | −۴۰٪ | $1.20 | $3.60 |
- Claude Opus 5.5−۵۰٪
- ورودی
- $2.00
رسمی: $4.00 - خروجی
- $10.00
رسمی: $20.00
- Claude Sonnet 5.5−۵۰٪
- ورودی
- $1.00
رسمی: $2.00 - خروجی
- $5.00
رسمی: $10.00
- GPT-6 Sol−۵۰٪
- ورودی
- $1.00
رسمی: $2.00 - خروجی
- $5.00
رسمی: $10.00
اشتراک ماهانهای در کار نیست؛ کیف پول را از ۱ دلار شارژ میکنی و فقط به اندازهٔ مصرف میپردازی. جدول کامل در صفحهٔ قیمتها و راهنمای اتصال ابزارها در مستندات است. اگر میخواهی بدانی خرید API از یک درگاه چه فرقی با مسیر رسمی دارد، خرید API Claude و GPT را بخوان.
سوالهای رایج
هر توکن چند کلمه است؟
در انگلیسی هر توکن حدود ۴ کاراکتر یا سهچهارم یک کلمه است؛ ۱٬۰۰۰ توکن تقریباً ۷۵۰ کلمه میشود. در فارسی هر کلمه معمولاً به توکن بیشتری شکسته میشود.
آیا پرامپت فارسی گرانتر از انگلیسی است؟
معمولاً بله، چون همان متن به فارسی توکن بیشتری میگیرد. در کار با کد اختلاف کم است، چون بیشتر ورودی کد و محتوای فایلهاست.
چرا توکن خروجی گرانتر از ورودی است؟
مدل ورودی را یکجا پردازش میکند اما خروجی را توکنبهتوکن میسازد. برای همین در بیشتر مدلهای Claude و GPT خروجی حدود ۵ برابر ورودی قیمت دارد.
اگر درخواست خطا بدهد، هزینه حساب میشود؟
در LLMPass نه. درخواستهای ناموفق هزینهای ندارند و فقط درخواستهای موفق از کیف پول کم میشوند.
LLMPass به Anthropic یا OpenAI وابسته است؟
نه. LLMPass یک سرویس مستقل است که با یک کلید API دسترسی به مدلهای Claude و GPT میدهد و وابستگیای به Anthropic یا OpenAI ندارد.
مطالب مرتبط
 قیمت
قیمت API Claude و GPT: هزینهٔ واقعی هر درخواست
قیمت رسمی مدلهای Claude و GPT را یکجا ببین، بفهم ورودی و خروجی و کش چطور حساب میشوند و هزینهٔ یک جلسهٔ واقعی Claude Code را با عدد حساب کن.
 آموزش
آموزش نصب و راهاندازی Claude Code قدمبهقدم
از نصب Claude Code تا اولین اجرا در ترمینال: تنظیم کلید API با متغیرهای محیطی یا settings.json، عوض کردن مدل، رفع خطاهای رایج و پایین نگه داشتن هزینه.
 راهنمای خرید
خرید API Claude و GPT بدون حساب Anthropic یا OpenAI
خرید API یعنی خرید اعتبار مصرفی، نه اشتراک. این راهنما دو راه خرید را مقایسه میکند و میگوید قبل از پرداخت چه چیزهایی را بررسی کنی.